Что видно в мониторинге 1С
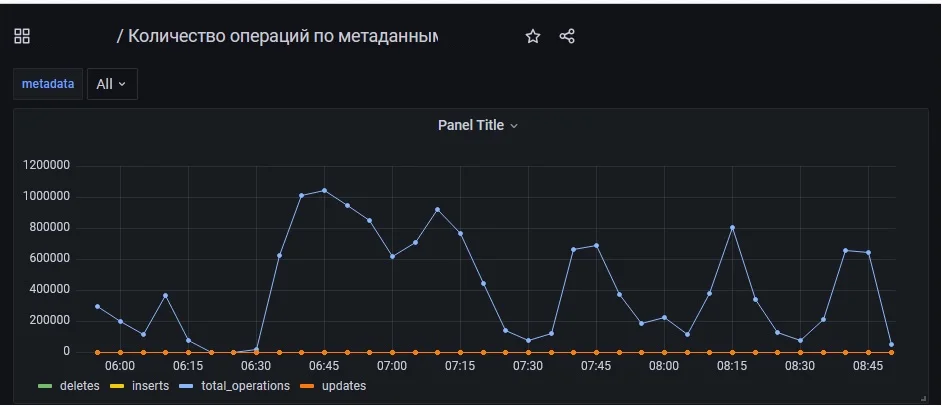
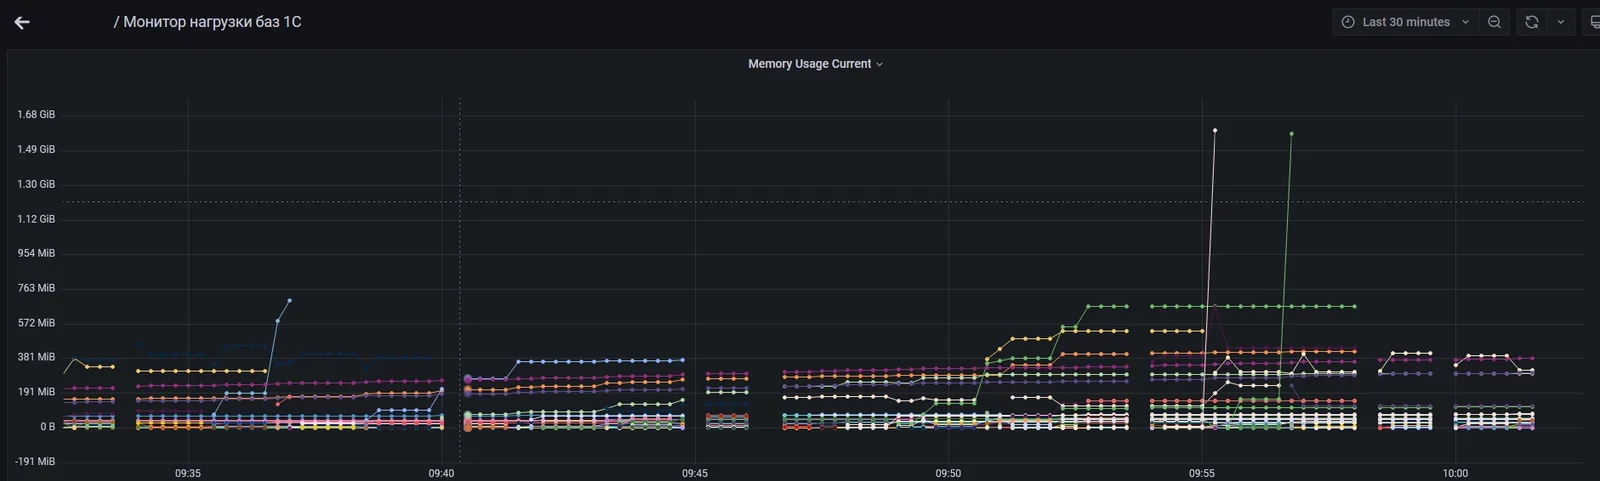
Правильный мониторинг отвечает на три вопроса: жив ли сервис, быстро ли работает система и что будет через месяц. Наше решение построено и обкатано на высоконагруженном продуктиве (ERP + WMS, несколько кластеров 1С) и собирает метрики на трёх слоях:
- СУБД (MS SQL Server) - 9 групп коллекторов: доступность, блокировки, память, ожидания, долгие запросы, Always On, tempdb и даже прикладные очереди прямо из таблиц 1С. Отдельный событийный сборщик опрашивает блокировки раз в секунду и фиксирует их полную историю - с текстами запросов и виновниками; дедлоки разбираются по графам из Extended Events.
- Кластер 1С (через RAS/RAC) - собственный экспортер: состояние rphost/ragent/rmanager, сессии, память процессов, лицензии; связка “SPID на SQL → конкретная сессия 1С” - на разборе инцидента видно, чей код держит сервер.
- Журналы регистрации → ClickHouse - события всех баз уходят в аналитическое хранилище почти в реальном времени; таблицы больше миллиарда событий остаются быстрыми для поиска. Ошибки, зависания, действия пользователей - всё ищется за секунды, а не листается в конфигураторе.
Поверх технических метрик - APDEX: замер скорости ключевых операций так, как их видит пользователь. Это главный показатель для руководителя: система “зелёная” не потому, что серверы живы, а потому, что людям быстро.
Если мониторинга ещё нет, а сервер уже грузится, историю нагрузки по процессам, сеансам и базам можно начать копить отдельной обработкой: анализ нагрузки кластера снимает её через тот же RAS.
Как данные 1С попадают в Prometheus и Grafana
Grafana сама ничего не хранит, она рисует графики из источников, поэтому “выгрузка 1С в Grafana” на деле состоит из двух потоков. Метрики уходят в Prometheus: он каждые 10-30 секунд опрашивает экспортеры, а экспортеры читают данные на месте. Для СУБД это sql_exporter поверх системных представлений SQL Server, для кластера 1С - наш экспортер, который ходит в кластер через RAS, для серверов - стандартные экспортеры CPU, памяти и дисков. События журналов регистрации идут вторым потоком, в ClickHouse, и Grafana подключает его как отдельный источник. Прикладные показатели тоже можно вывести на дашборд: коллекторы СУБД читают очереди прямо из таблиц 1С, без доработки конфигурации. Подробный разбор архитектуры с таблицей метрик - в статье “Мониторинг 1С в Grafana”.
Решение в цифрах
- 3 слоя мониторинга: СУБД, кластер 1С, журналы регистрации
- 50+ метрик Prometheus и 12+ правил алертинга только по слою СУБД
- Блокировки - опрос раз в секунду, кластер 1С - каждые 10 секунд
- > 1 млрд событий журнала регистрации на базу в ClickHouse без потери скорости поиска
- Стек: Prometheus, Grafana, Loki, ClickHouse, Alertmanager - открытый, без лицензионных платежей
Почему Grafana + Prometheus
Это открытый индустриальный стандарт: без лицензионных платежей, с огромной экосистемой и без привязки к подрядчику. Всё, что мы развернём, остаётся у вас - с документацией и настроенными правами. Захотите - сопровождаем, захотите - обслуживаете сами.
Журнал регистрации в ClickHouse: наблюдаемость на миллиардах событий
Для нагруженных баз в мониторинг входит отдельный контур - выгрузка журнала регистрации в ClickHouse в реальном времени. Штатный журнал на потоке в десятки миллионов событий в сутки перестаёт открываться; после выноса в колоночное хранилище поиск ошибок за сутки занимает доли секунды, история хранится месяцами, а пользователи работают в привычной форме журнала - не зная, что под ней миллиарды строк. Поверх - Telegram-алерты о сбоях потока и AI-анализ ошибок. Для базы без ClickHouse повторяющиеся ошибки, задания и входы можно разобрать нейросетью по снимку: журнал регистрации для нейросети сохраняет его в Markdown и Excel.
Работает это в бою: на внедрении с потоком 170 млн событий в сутки (пики - 11 300 событий в секунду) поиск по суткам занимает 0,11 секунды, а число ошибок в проде за полгода наблюдаемости снизилось в 23 раза. Полные цифры - в кейсе “Журнал регистрации в ClickHouse: 35 млрд событий”.
Алерты, которые не надоедают
Главная болезнь мониторинга - алерты, которые все игнорируют. Мы настраиваем пороги в два этапа: сначала “обкатка” на реальной нагрузке, затем тонкая подстройка, чтобы уведомление в Telegram означало ровно одно: нужно действовать. Падение rphost, рост очереди обмена, заканчивающееся место, деградация APDEX - вы узнаёте об этом за минуты, а о трендах - за недели до того, как они станут аварией.