Контекст
У клиента - розничной сети с ювелирным ассортиментом - в базе 1С больше 12 000 фотографий номенклатуры: кольца, серьги, браслеты, цепи, колье.
Специфика в том, что одна модель изделия заводится десятками отдельных карточек. Разные размеры, партии и поставки, у каждой - свой код и артикул. Для учёта это правильно: у каждой позиции свой вес, проба и себестоимость. Для аналитики - катастрофа: отчёт по остаткам показывает 40 строк там, где по факту одна модель. Спланировать закупку или увидеть залежавшееся невозможно.
Почему нельзя решить текстом
Первое, что пробуют все, - сгруппировать по наименованию или артикулу. Не работает: в наименованиях зашиты партия, размер и вес, артикулы у каждой партии свои, а папки справочника организованы по поставщикам и коллекциям, а не по внешнему виду.
Единственный признак, по которому изделия действительно одинаковые, - как они выглядят. А это фотография.
Почему нельзя решить руками
“Найти среди фотографий одинаковые” - это попарное сравнение. Для 1 622 фотографий честное “каждая с каждой” - 1 314 631 пара. На всей базе - за 70 миллионов.
Даже умный ручной подход (раскладывать по кучкам, ~2 минуты на фото) даёт ≈ 54 часа на срез и ≈ 400 часов на базу - 2,5 месяца работы, которую придётся повторять после каждого поступления. И главное: два сотрудника разложат один и тот же ассортимент по-разному, а один и тот же сотрудник в понедельник и в пятницу - тоже по-разному.
Решение: пайплайн из пяти звеньев
Две обработки 1С по краям, AI-звено посередине.
Этап 1. Выгрузка. Внешняя обработка достаёт двоичные данные присоединённых файлов номенклатуры через штатное API, складывает изображения в каталог и пишет файл соответствия: код, наименование, артикул, полный путь в иерархии справочника.
Этап 2. AI-классификация. Каждое фото уходит в модель со зрением. Промпт задаёт роль эксперта по визуальной классификации и требует определить тип изделия, форму, вставки, плетение и конструкцию - 2-5 слов на русском: “Кольцо фасонное ажурное”, “Цепь плетение Бисмарк”.
Ключевое решение: модели запрещено упоминать металл и пробу. Отличить белое золото 750 от серебра 925 по фото практически невозможно - зато эти данные точно есть в учёте. AI отвечает за визуальный дизайн, металл и проба подставляются из дополнительных реквизитов 1С. Итоговое имя сегмента собирается из двух источников: “Кольцо обручальное гладкое” + “Золото 750”.
Второе правило: анализировать только визуал. Если дать модели наименование, она начинает классифицировать по названию коллекции - и одинаковые изделия из разных коллекций разъезжаются по разным сегментам.
Этап 3. Консолидация синонимов. Модель на разных пачках формулирует одно и то же по-разному: “Цепь Бисмарк” и “Цепь плетение Бисмарк”. Второй проход - текстовый - схлопывает синонимы с жёсткими запретами: не объединять разные камни, не объединять разные типы изделий. С режимом предпросмотра: сначала показать замены, потом применять.
Этап 4. Выбор обложки. У сегмента из 180 позиций - 180 фотографий, в интерфейс нужна одна. AI выбирает лучшую: резкость, освещение, изделие целиком, чистый фон.
Этап 5. Импорт в 1С. Вторая обработка создаёт иерархический справочник сегментов с фото-обложками и заполняет регистр сведений “номенклатура → сегмент” - привязка доступна в любом запросе и отчёте. Металл и проба вытягиваются одним пакетным запросом по всем позициям сразу.
Что пошло не так - и как это закрыли
Честный раздел, потому что именно здесь тратится инженерное время.
| Проблема | Решение |
|---|---|
| Прогон на несколько часов упирается в суточные лимиты API | Возобновление с места остановки: при старте читается готовый результат, обрабатываются только новые фото. Результат сохраняется после каждой пачки, а не в конце |
| Модель возвращает обрезанный JSON, упираясь в лимит токенов ответа | Четырёхступенчатый разбор: снять markdown-обёртку → распарсить как есть → вырезать массив из текста → достроить обрезанный JSON до последнего целого объекта |
| Синонимы категорий | Отдельный проход консолидации с предпросмотром |
| Один и тот же снимок привязан к разным карточкам | Склейка по хэшу изображения до AI-обработки: байтово одинаковые файлы гарантированно в одном сегменте |
| AI ошибается на нетипичных ракурсах | Товар остаётся без сегмента и попадает в ручной разбор. Ошибки локализованы и видны, а не размазаны по базе |
Перед каждым необратимым шагом - снимок состояния: консолидацию, склейку и объединение можно откатить. Весь пайплайн отработал на копии; в продуктив перенесён только принятый результат - отдельной обработкой.
Результаты
| Показатель | Значение |
|---|---|
| Обработано фотографий | 1 622 |
| Позиций номенклатуры | 1 594 |
| Товарных групп в срезе | 10 |
| Получено визуальных сегментов | 289 |
| Коэффициент свёртки отчёта | 5,6× |
| Сегментов с 10+ позициями | 34 |
| Потрачено на AI-инференс | 0 ₸ |
Топ сегментов: “Кольцо обручальное гладкое” - 180 позиций, “Кольцо фасонное с камнями” - 138, “Кольцо дорожка с камнями” - 103. Читается так: строка “Кольцо обручальное гладкое” в отчёте по остаткам заменила собой 180 отдельных строк. Десять верхних сегментов свернули почти половину среза.
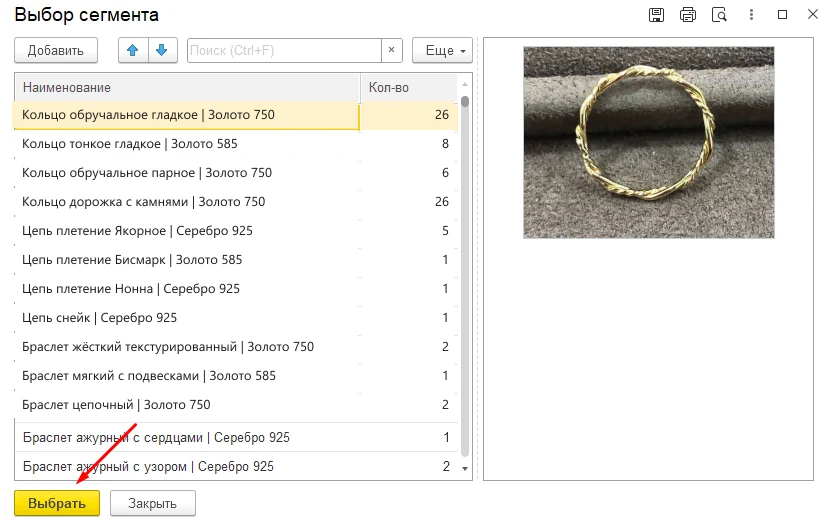
Выбор сегмента в интерфейсе выглядит так - фото-обложка, поиск, счётчик привязанных товаров:
Второй эффект, ради которого стоило начинать
Сегменты делались ради отчётов. По ходу проекта выяснилось, что у них есть применение ценнее: сегмент - это шаблон для заведения новых товаров.
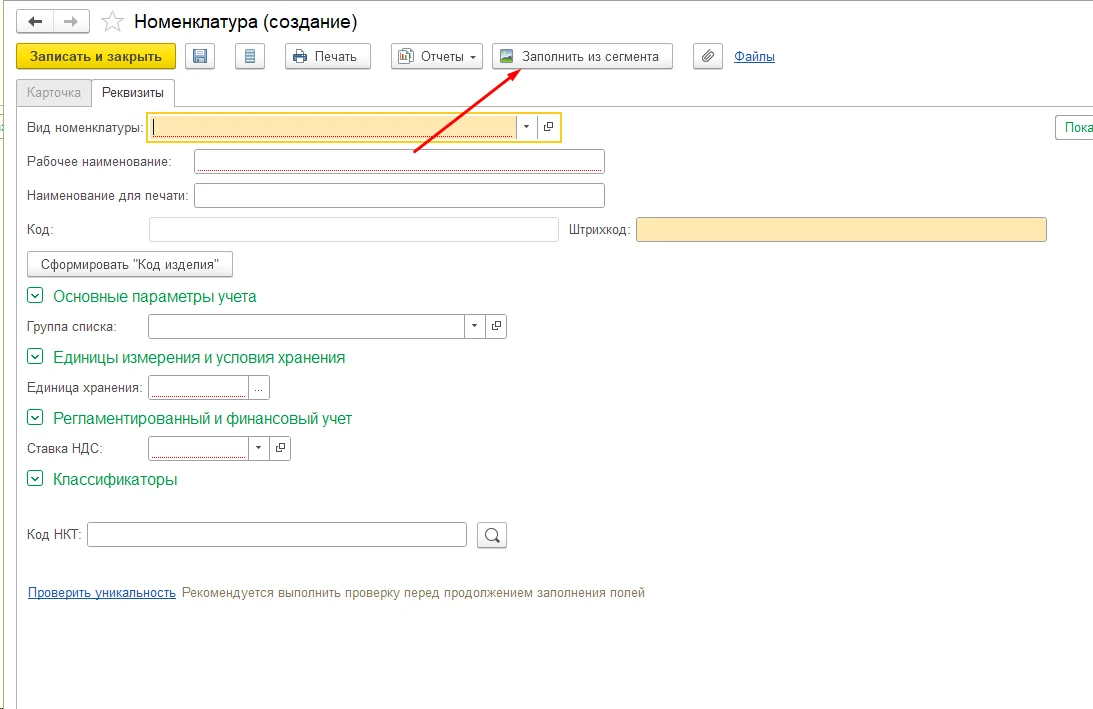
Пришла новая партия колец той же модели - менеджер создаёт карточку, жмёт “Заполнить из сегмента”, выбирает сегмент по фотографии. Переносятся наименование, реквизиты карточки, дополнительные свойства и фото - ссылкой на тот же файл, без дублирования в томах хранения.
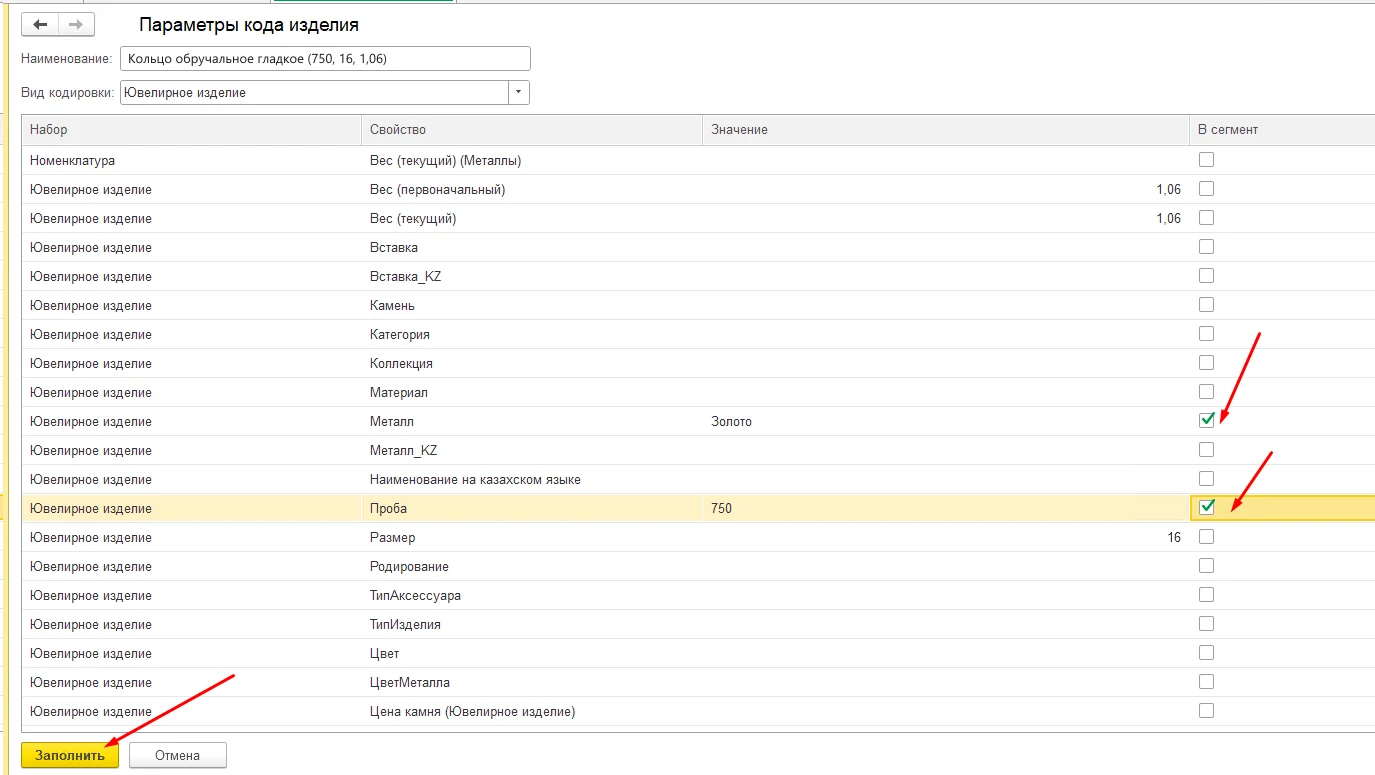
У каждого свойства есть флаг “В сегмент”: отмеченные значения записываются в образец и подставляются автоматически у следующих товаров. Образец дообучается по мере работы.
Что осталось у клиента
Девять объектов в базе 1С: обработки выгрузки, импорта, ручной досегментации и переноса в прод, отчёты по остаткам и продажам в разрезе сегментов. Плюс скрипты пайплайна с исходным кодом - повторный прогон на новых поступлениях не требует нашей команды. Плюс две инструкции пользователя со скриншотами, собираемые генератором: изменился интерфейс - инструкция пересобирается одной командой.
Сегменты и привязка - обычные объекты 1С: результат живёт бессрочно, внешние сервисы после прогона не нужны.
Пилот прошёл на срезе в 1 622 фото; решение масштабируется на все 12 000+ без изменений в архитектуре - 2-3 дня прогона.
Как устроена услуга и сколько стоит - на странице AI-сегментации товаров по фото.
Как устроен сам метод - когда он применим, из каких звеньев собран и на каких граблях спотыкается - разобрано отдельно: как свернуть дубли карточек номенклатуры нейросетью по фото. А технический разбор проекта - с промптами, разбором обрезанного JSON на длинных пачках и учебным Python-скелетом классификатора - опубликован на Инфостарте: “180 карточек одного кольца”.